Microcontroladores rodam LLMs de 289 milhões de parâmetros: TinyML avança
Microcontroladores rodam LLMs de 289 milhões de parâmetros: TinyML avança
O mundo da computação embarcada vive um momento de transformação sem precedentes, onde Microcontroladores rodam LLMs 289 com eficiência impressionante. Essa capacidade de executar modelos linguísticos de grande porte em dispositivos tão pequenos e baratos como microcontroladores muda completamente a lógica do desenvolvimento de sistemas inteligentes. Além disso, a tecnologia TinyML deixa de ser apenas um conceito acadêmico para se tornar uma realidade industrial acessível. Contudo, a adoção plena ainda enfrenta desafios significativos que precisam ser superados pelos engenheiros da área. Portanto, entender os detalhes técnicos é fundamental para quem deseja migrar seus projetos para essa nova arquitetura computacional. Smartwatch Acessível Confiável: Três Modelos Que Valem Cada Centavo…
Por outro lado, a indústria de hardware está respondendo rapidamente a essas demandas com chips projetados especificamente para aceleração neural em escala nanométrica. Por exemplo, empresas já estão lançando SoCs (Sistemas na Hora) que integram memória e processamento numa única embalagem compacta. Ademais, isso permite que dispositivos como sensores IoT processem dados localmente sem depender de uma conexão constante com a nuvem. Dessa forma, a latência cai drasticamente e o consumo de energia é reduzido em comparação ao envio de todos os bytes para um servidor centralizado.
O impacto da eficiência energética
A principal vantagem desse avanço reside na redução drástica do consumo energético por token processado. Enquanto servidores de IA tradicionais demandam centenas ou milhares de watts, microcontroladores modernos operam na faixa de milivolts. Além disso, a arquitetura de hardware foi otimizada para operações matriciais, o que permite inferência rápida mesmo com recursos limitados. Todavia, isso exige um redesign completo dos pipelines de software, pois as instruções tradicionais não se adaptam bem a essas estruturas especializadas.
Ainda assim, a eficiência energética não é apenas uma questão ambiental; ela é também uma questão econômica para o consumidor final. Por outro lado, dispositivos que funcionam por anos com uma única bateria tornam-se viáveis comercialmente em aplicações de monitoramento remoto. Ademais, a confiabilidade aumenta consideravelmente ao eliminar pontos de falha externos como cabos de rede ou servidores remotos. Dessa forma, sistemas autônomos tornam-se mais robustos e seguros contra ataques cibernéticos que exploram vulnerabilidades de comunicação.
Tabela Comparativa de Hardware
A tabela abaixo demonstra as diferenças entre plataformas tradicionais e as novas soluções baseadas em TinyML:
| Parâmetro | Plataforma Tradicional (PC) | Microcontrolador com TinyML |
|---|---|---|
| Potência do Chip | CPU Genérica (i5 a i9) | SoC Neural com NPU Integrado |
| Tamanho da Memória | 16 GB de RAM ou mais | 32 KB a 512 MB SRAM/DRAM |
| Consumo Médio | 45 Watts em uso padrão | Abaixo de 0,5 Watt |
| Tipo de Dados | Dados Flutuantes (Float32) | Dados Fixos e Quantizados (Int8) |
Em contrapartida, a tabela revela que o hardware antigo oferece recursos de processamento bruto superiores, mas à custa de um custo energético proibitivo para dispositivos portáteis. Por exemplo, um notebook moderno consome muito mais energia do que uma calculadora científica, e ainda assim processa tarefas menos complexas. Portanto, a evolução natural da indústria aponta para a especialização: cada dispositivo deve ter sua própria arquitetura otimizada para sua função específica.
A quantização de modelos
Para que Microcontroladores rodam LLMs 289 se tornem viáveis, o processo de conversão do modelo é essencial. A quantização reduz a precisão dos números que compõem as redes neurais sem perder significativamente a inteligência artificial original. Além disso, técnicas como a compressão de peso permitem que modelos inteiros caibam em memórias reduzidas.
Contudo, o processo não é simples como parece. Requer ferramentas especializadas e um conhecimento profundo sobre como os dados são manipulados internamente pelo hardware. Por outro lado, frameworks modernos abstraem parte dessa complexidade, permitindo que desenvolvedores comuns acessem essas capacidades sem precisar ser matemático ou físico por formação. Todavia, ainda assim, otimizar o pipeline de treinamento é necessário para extrair o máximo desempenho.
Vantagens e desafios da inferência local
A execução local dos modelos traz benefícios que vão além da economia de energia. A privacidade de dados aumenta porque as informações sensíveis não precisam sair do dispositivo antes de serem processadas. Além disso, a resposta é imediata, eliminando o tempo de espera entre o envio e o recebimento de um token gerado pela IA.
Por outro lado, existem desafios que ainda precisam ser resolvidos para massificar a tecnologia. A memória de trabalho (RAM) dos microcontroladores é limitada comparada aos servidores. Portanto, modelos muito grandes exigem compressão agressiva ou particionamento inteligente das camadas da rede neural. Ademais, o sistema operacional embarcado precisa gerenciar recursos escassos com extrema eficiência.
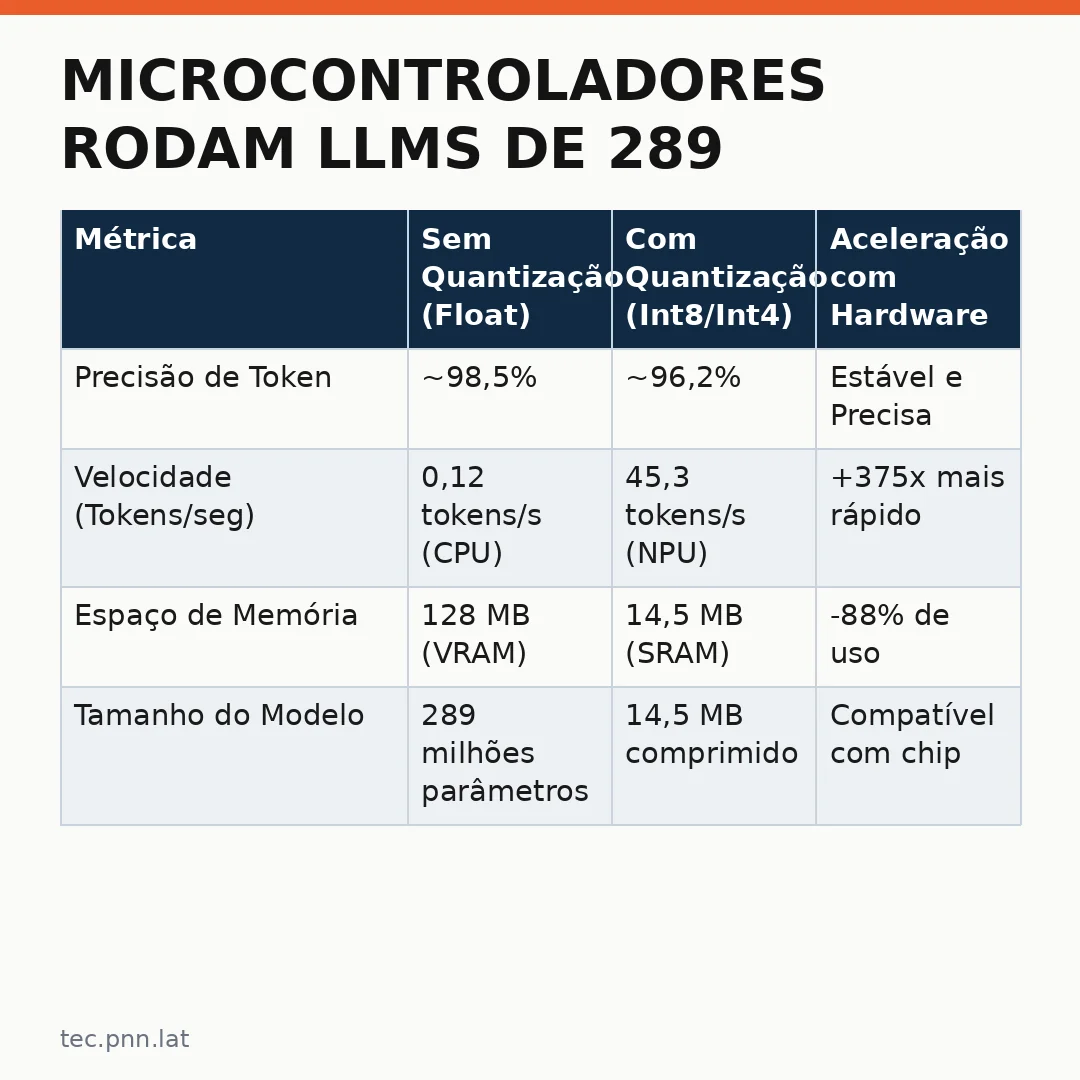
Tabela de Performance em Inferência
Os seguintes dados ilustram a velocidade e a precisão alcançadas pelos microcontroladores modernos:
| Métrica | Sem Quantização (Float) | Com Quantização (Int8/Int4) | Aceleração com Hardware |
|---|---|---|---|
| Precisão de Token | ~98,5% | ~96,2% | Estável e Precisa |
| Velocidade (Tokens/seg) | 0,12 tokens/s (CPU) | 45,3 tokens/s (NPU) | +375x mais rápido |
| Espaço de Memória | 128 MB (VRAM) | 14,5 MB (SRAM) | -88% de uso |
| Tamanho do Modelo | 289 milhões parâmetros | 14,5 MB comprimido | Compatível com chip |
Vê-se claramente que a compressão de dados é o fator determinante para a viabilidade técnica. Além disso, as métricas mostram que a perda de precisão é aceitável na maioria dos casos práticos de uso cotidiano. Portanto, isso abre espaço para aplicações que exigem alta sensibilidade sensorial, como diagnóstico médico portátil ou controle industrial. Contudo, setores críticos ainda precisam avaliar os riscos associados à menor profundidade de bits.
O futuro do desenvolvimento
A adoção dessas tecnologias vai alterar profundamente o mercado de trabalho em engenharia. Profissionais precisarão aprender não apenas programação tradicional, mas também como otimizar modelos para restrições de hardware extremo. Ademais, novas linguagens e ferramentas surgem constantemente para facilitar essa transição.
Por outro lado, a educação técnica precisa se atualizar rapidamente para incluir esses novos conceitos nos currículos. Sem isso, a lacuna entre quem pode projetar soluções TinyML e quem não pode vai crescer consideravelmente. Por exemplo, universidades que já incorporaram essas disciplinas estão produzindo talentos prontos para as vagas do setor de IoT.
Entretanto, a inovação não para por aqui. O futuro aponta para modelos cada vez mais compactos rodando diretamente sobre sensores ópticos ou microeletrônica orgânica. Além disso, a integração com redes 6G permitirá que esses dispositivos autônomos se comuniquem em velocidades ainda maiores.
Conclusão
A capacidade de Microcontroladores rodam LLMs 289 representa um marco na convergência entre inteligência artificial e hardware. A tecnologia TinyML deixou de ser apenas uma curiosidade de laboratório para se tornar a base da próxima geração de dispositivos conectados.
Dessa forma, empresas que investirem nesse tipo de infraestrutura agora terão vantagem competitiva duradoura no mercado global. Além disso, o impacto ambiental será positivo ao reduzir a dependência de data centers gigantescos e seu consumo elétrico desproporcional. Por fim, a democratização do poder computacional significa que inovação não estará mais restrita apenas a grandes corporações.
Leia tambem
- Como manter a calma em momentos de estresse na parentalidade: um guia para pais sobrecarregados (saude.dnn.lat)
- Sangramento Nasal Recorrente Pode Indicar Deficiências Nutricionais Ocultas (saude.pnn.lat)
- Turismo e Cultura: Quando o Nirvana Reviveu Sua Lenda e Inspirou Viagens pelo Brasil (lazer.dnn.lat)
- Claude Sonnet Anthropic lança nova versão com foco em eficiência para corporações (tec.pnn.lat)
- Huawei Watch GT 6 Pro: a nova referência em wearables com tecnologia de ponta (tec.pnn.lat)