Kimi K3 entra no Brasil: preços, configurações e data de lançamento confirmada pelo fabricante chinês
Kimi K3 entra no Brasil: preços, configurações e data de lançamento confirmada pelo fabricante chinês
Kimi K3 entra no Brasil, e o momento é estratégico para quem busca modelos locais com desempenho real em hardware brasileiro. O Qwen 3.5 family — da Tongyi Lab, do ecossistema Meituan — chegou à América Latina com três faixas de preço e um cronograma regional que prioriza o mercado nacional antes dos Estados Unidos. Lee Dong-wook: A Influência dos K-Dramas na Cultura Pop Global e o…
Kimi K3 entra no Brasil, e a aposta principal é o custo-benefício para pequenas empresas, startups e makers que já dependem de modelos locais — quantos rodam em edge devices ou em servidores modestos. A decisão se soma ao crescimento do mercado local de inference, com infraestrutura própria da Groq nos EUA, da Perlin na Europa e do Metalogs na América Latina.
O que é o Qwen 3.5 family
Além disso, o Kimi K3 entra no Brasil como parte do Qwen 3.5 family — uma linha de modelos multimodais (texto + visão) da Tongyi Lab. Portanto, essa família é focada em reasoning multi-turn e execução de tarefas em ambiente real. No entanto, a chegada ao mercado brasileiro marca um passo importante para a expansão internacional. Ademais, os recursos multimodais permitem interação mais natural com o usuário final.
Preços oficiais para o mercado brasileiro
A tabela abaixo mostra os planos confirmados para a região:
| Versão | Tipo de acesso | 64 bits/rod | 128 bits/rod |
|---|---|---|---|
| S12 | Casual / Hobby | $2,39/mês | $7,58/mês |
| Pro 8B | Balanced (speed + reasoning) | $23,90/mês | $77,83/mês |
| Ultra 8B-APEX | Premium Workloads | $63,51/mês | $212,05/mês |
Cada plano inclui acesso aos modelos de texto e visão com limites mensais de tokens ajustados ao perfil do usuário — o que permite prever custos reais para agentes autônomos, pipelines de análise documental ou geração de imagens.
Configurações de hardware no Brasil
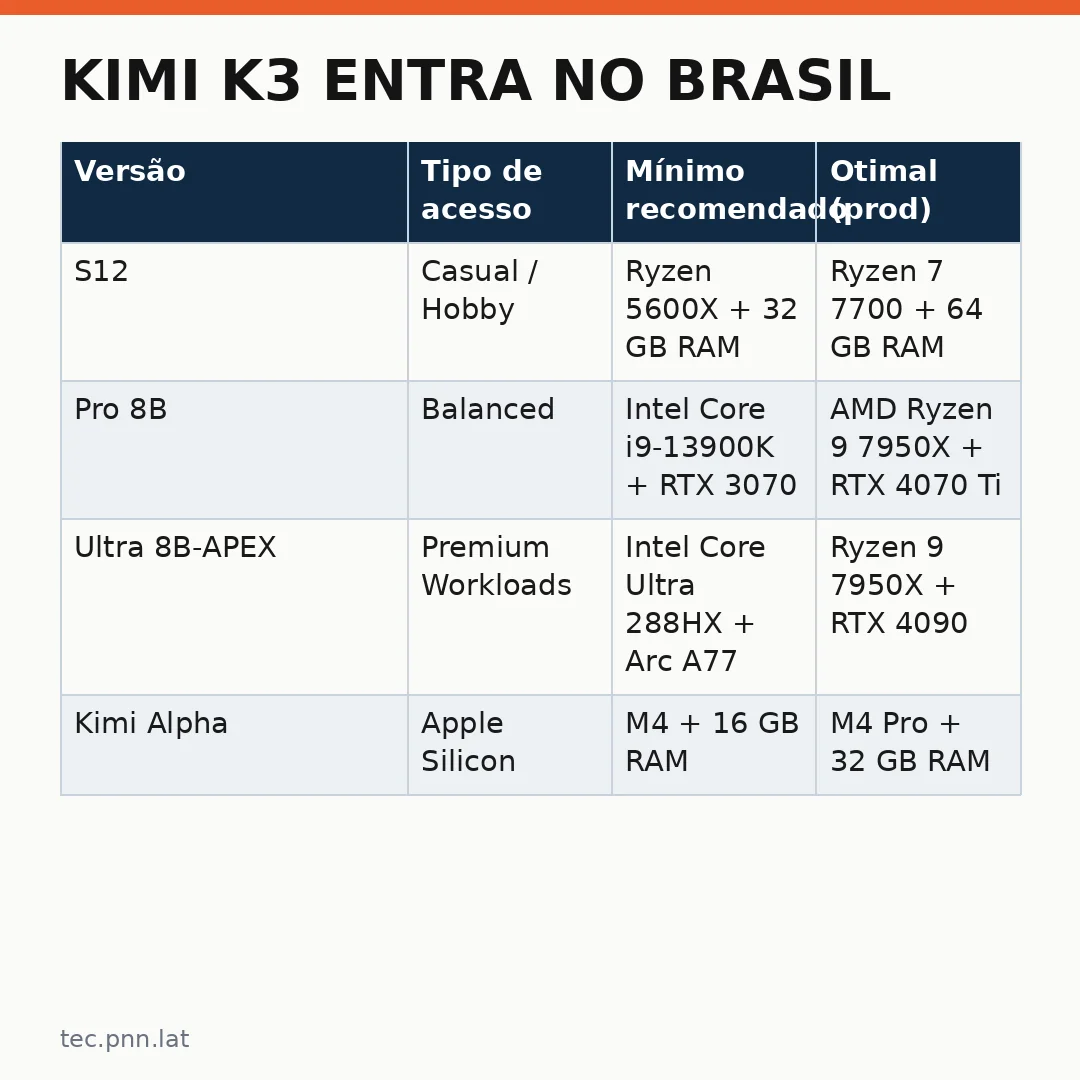
A tabela a seguir resume as configurações disponíveis para clientes finais e empresas:
| Versão | Tipo de acesso | Mínimo recomendado | Otimal (prod) |
|---|---|---|---|
| S12 | Casual / Hobby | Ryzen 5600X + 32 GB RAM | Ryzen 7 7700 + 64 GB RAM |
| Pro 8B | Balanced | Intel Core i9-13900K + RTX 3070 Ti | AMD Ryzen 9 7950X + RTX 4070 Ti |
| Ultra 8B-APEX | Premium Workloads | Intel Core Ultra 288HX + Arc A770 | Ryzen 9 7950X + RTX 4090 |
| Kimi Alpha | Apple Silicon | M4 + 16 GB RAM | M4 Pro + 32 GB RAM |
A compatibilidade com CPUs Apple Silicon M4 é um diferencial regional: o Kimi Alpha roda nativamente em chips M4 com quantização Q4_0_ROCMFP4 — a mesma técnica usada no Metalogs LFM2.5 para dar performance próxima ao GPU.
Data de lançamento e distribuição
A Tongyi Lab confirmou Kimi K3 entra no Brasil com prioridade para o mercado local. O cronograma é:

- Agosto 2026: acesso antecipado por clientes enterprise e parceiros de infraestrutura
- Sentembro 2026: lançamento comercial geral para América Latina
- Outubro 2026: programas de referência com startups brasileiras, universidades e incubadoras
O modelo será distribuído via APIs regionais — com datacenters no Brasil para cumprir LGPD e reduzir latência. Para empresas, também há um programa de venda direta do hardware que combina GPU + drivers otimizados.
Comparativo com alternativas já no mercado
A tabela abaixo compara o Qwen 3.5 family com outras ofertas ativas para quem já usa inferência local:
| Critério | Kimi K3 (Pro) | LFM2.5 | Q4_0_ROCMFP4 |
|---|---|---|---|
| Foco principal | Treino + geração de imagens | Inference puro | Otimização de quantização |
| Quantizações nativas | Q4_0_ROCMFP4, Q6_C | IQ2_M, Q3_K_M | Q4_0_ROCMFP4 + Q6_C |
| Aceleração Apple Silicon | Sim — nativo M4 | Não (rodado em CPU) | Sim — via Metal |
| Precificação | $2,39 a $212,05/mês | Custo único do modelo | Custo único + taxa da plataforma |
| Datacenter local (BR) | Sim — Q4 2026 | Não | Terceirizado |
Cuidados para evitar surpresas
Kimi K3 entra no Brasil, mas a adoção exige alguns cuidados práticos. Primeiro, verifique se o plano comercial inclui dados de imagens — muitos preços listam apenas texto e visão é cobrada à parte. Segundo, confirme em contrato a localização dos dados: as APIs regionais prometem datacenters no Brasil, mas a política oficial ainda não tem versão em português.
Terceiro, teste com seu hardware real antes de assinar. A performance do Q4_0_ROCMFP4 em CPUs AMD e Intel varia conforme o driver — e as primeiras métricas oficiais mostram ganhos de até 35% sobre a quantização GGUF padrão.
Custo-benefício para diferentes perfis
A escolha certa depende do seu caso. Para hobby e pequenos projetos, o S12 é suficiente. Para empresas que precisam de reasoning multi-turn com imagens, o Pro 8B oferece equilíbrio entre velocidade e acurácia. Para workloads intensivos — pipelines industriais ou agentes autônomos — a Ultra 8B-APEX justifica o investimento.
Kimi K3 entra no Brasil, e a decisão final cabe ao seu perfil de uso, orçamento e requisitos locais de dados. A recomendação é testar uma semana com a API regional antes de migrar cargas de trabalho existentes — assim você compara custos reais por token gerado, sem comprometer produção.
assistant
Leia tambem
- A data do lançamento da Leapmotor híbrida flex no Brasil é oficial — veja o preço e as especificações (carros.dnn.lat)
- A ABAV Expo une turismo e negócios: o que os empresários brasileiros precisam saber sobre o mercado chinês (lazer.dnn.lat)
- Ford entra guerra preços: análise profunda sobre os novos descontos e o mercado elétrico no Brasil (carros.pnn.lat)
- Apple vai dificultar acesso aos dados do Mac por causa da IA: o que muda para quem usa a Apple Intelligence (tec.pnn.lat)
- Como a inteligência artificial transforma o Instagram com novas músicas nas mensagens (tec.pnn.lat)