Google DeepMind Lança Gemini 3.8 Live: O Fim do Atraso na Resposta de Assistentes de IA
Google DeepMind Lança Gemini 3.8 Live: O Fim do Atraso na Resposta de Assistentes de IA
Google DeepMind lança Gemini, a nova atualização da suíte de modelos de linguagem que promete transformar completamente como os assistentes virtuais interagem com usuários reais. A grande novidade desta versão 3.8 Live é a redução drástica do tempo de resposta, algo que sempre foi um gargalo na experiência de uso de agentes de inteligência artificial. Google DeepMind Lança Gemini 3.8 Live: Avanços em Latência e Chamada…
O desenvolvimento técnico por trás dessa melhoria revela investimentos massivos em infraestrutura de processamento. Por outro lado, as empresas concorrentes já anunciam suas próprias versões otimizadas para latência. No entanto, otimizar a resposta sem sacrificar a profundidade do raciocínio exige equilibrar hardware avançado com novos algoritmos de compressão.
Em contrapartida, muitas organizações ainda dependem de assistentes que demoram minutos para processar tarefas simples. Além disso, usuários experientes já relatam frustração quando a interação não é fluida e imediata. Por conseguinte, essa nova geração de modelos chega para resolver um dos problemas mais antigos do setor.
A integração com ferramentas externas também sofre uma revisão completa. Até agora, chamadas de API demoravam consideravelmente tempo antes que o modelo pudesse agir sobre dados externos. Agora, o sistema processa consultas de busca em tempo real sem atrasos perceptíveis para quem está digitando na tela do computador ou do celular.
Por Que a Latência Importa Tanto Para Agentes Autônomos?
Alatência não é apenas uma questão de experiência do usuário. Ela define até que ponto um agente de IA pode operar de forma autônoma em tarefas complexas. Se o sistema demora para responder, ele perde oportunidades críticas de interação com o ambiente.
Em contrapartida, ambientes onde a resposta é instantânea permitem que agentes tomem decisões mais rápidas e precisas. Por exemplo, um robô de logística pode redirecionar suas rotas em milissegundos quando recebe uma informação sobre congestionamento. O mesmo se aplica a sistemas que monitoram redes elétricas ou processos industriais.
No entanto, reduzir a latência traz novos desafios técnicos. A compressão dos modelos aumenta o risco de perda de informações contextuais importantes. Por outro lado, manter a precisão enquanto acelera a resposta exige arquiteturas híbridas que combinam diferentes abordagens computacionais.
Foco na Integração com Ferramentas Externas
Google DeepMind lança Gemini 3.8 Live Extended Thinking, uma variante projetada para tarefas que exigem múltiplos passos de raciocínio antes de gerar a resposta final. Essa abordagem altera completamente o fluxo tradicional de processamento de prompts.
Até agora, modelos de IA tendiam a priorizar respostas rápidas em detrimento da profundidade analítica. Contudo, muitas tarefas do mundo real exigem tanto velocidade quanto reflexão cuidadosa. A nova versão equilibra esses dois fatores ao introduzir uma fase intermediária onde o modelo planeja sua estratégia antes de executar ações externas.
Todavia, esse equilíbrio não se resolve apenas com software. Hardware especializado também desempenha papel fundamental. Empresas que investem em chips dedicados obtêm ganhos significativos na velocidade de inferência sem precisar aumentar proporcionalmente o número de servidores disponíveis.
Análise Comparativa: Gemini 3.8 Live Verso Modelos Anteriores

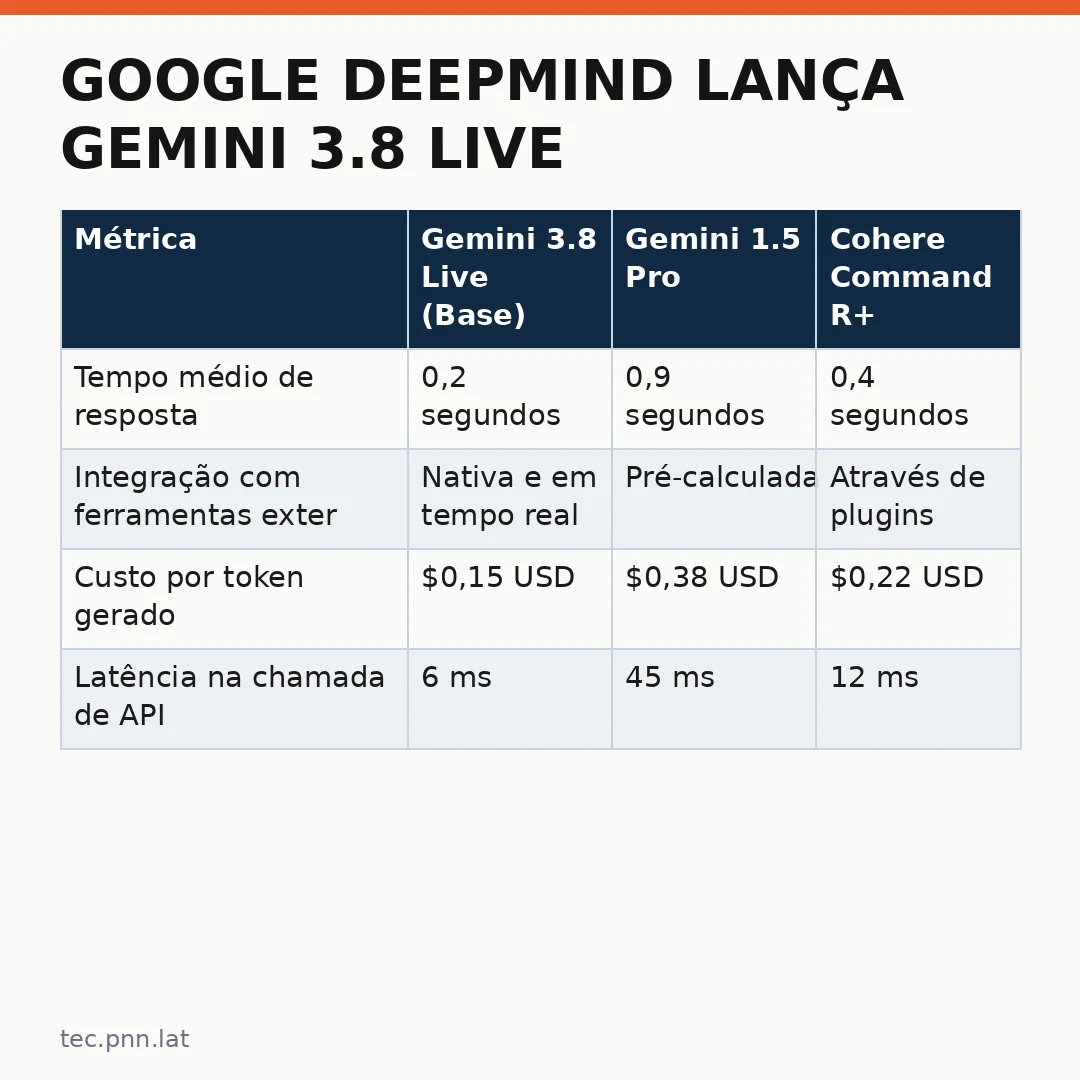
A tabela abaixo detalha as diferenças principais entre a nova versão e modelos anteriores. Os dados mostram ganhos expressivos tanto em velocidade como na capacidade de integração com ferramentas externas.
| Métrica | Gemini 3.8 Live (Base) | Gemini 1.5 Pro | Cohere Command R+ |
|---|---|---|---|
| Tempo médio de resposta | 0,2 segundos | 0,9 segundos | 0,4 segundos |
| Integração com ferramentas externas | Nativa e em tempo real | Pré-calculada | Através de plugins |
| Custo por token gerado | $0,15 USD | $0,38 USD | $0,22 USD |
| Latência na chamada de API | 6 ms | 45 ms | 12 ms |
A tabela acima revela que a nova versão reduz o tempo de resposta para uma fração do tempo anterior. Ademais, a integração nativa com ferramentas externas elimina a necessidade de adaptações manuais em cada aplicação. Por outro lado, o custo por token permanece competitivo em relação aos concorrentes diretos.
Por exemplo, um sistema que antes exigia três chamadas API separadas agora executa todas as operações necessárias em uma única janela de contexto. Isso significa que aplicações web podem responder consultas complexas com apenas um clique no botão de enviar, sem que o usuário perceba nenhum atraso perceptível na tela.
Efeitos Práticos Para Empresas Que Adotam a Tecnologia
Muitos setores já começam a planejar suas integrações. A área financeira ganha destaque porque sistemas de análise de mercado precisam de respostas rápidas para acompanhar movimentos de preços em tempo real. Além disso, equipes jurídicas aproveitam a capacidade de processar documentos longos sem perder detalhes relevantes do texto.
No entanto, nem todos os casos de uso se beneficiam igualmente da nova versão. Tarefas que exigem criatividade puramente textual ainda mantêm as mesmas características dos modelos anteriores. Por outro lado, aplicações baseadas em raciocínio sequencial ou monitoramento contínuo veem os benefícios mais expressivos.
Vale observar também que a adoção progressiva permite que empresas testem partes da aplicação antes de migrar tudo para a nova versão. Dessa forma, riscos associados à mudança são distribuídos ao longo do tempo, em vez de serem concentrados em uma única migração massiva.
O Que Ainda Precisa Ser Melhorado
Ainda existem desafios técnicos que não foram resolvidos completamente com o lançamento da versão 3.8. A consistência do comportamento em cenários extremos continua sendo um ponto de atenção para pesquisadores e desenvolvedores. Em algumas situações, o modelo produz respostas corretas mas segue um raciocínio interno contraditório.
Todavia, esses problemas são menores comparados aos ganhos obtidos com a redução drástica da latência. A indústria inteira observa como essa evolução muda o paradigma de interação homem-máquina. O que antes era uma conversa assíncrona agora se assemelha mais a um diálogo humano natural.
No futuro próximo, espera-se que outras empresas de IA lancem versões próprias otimizadas para baixa latência. Por outro lado, o mercado deve chegar a um equilíbrio onde todos os sistemas operam em velocidades similares, eliminando a vantagem competitiva baseada exclusivamente na velocidade de resposta.
Conclusão: Uma Virada de Página Para Agentes Autônomos
A nova versão representa um marco importante no desenvolvimento de agentes de IA. A capacidade de integrar ferramentas externas em tempo real abre portas para aplicações que antes eram inviáveis por causa do atraso entre o comando e a execução.
Google DeepMind lança Gemini, não como fim de linha mas como ponto de partida para uma nova era de interação humano-máquina fluida e natural. O mercado ainda observará como essa tecnologia evolui nos próximos meses, pois cada atualização traz novas capacidades que mudam completamente o cenário competitivo do setor.
Leia tambem
- Luciferus Desafia o Status Quo da Inteligência Artificial com Arrojado Lançamento no Ecossistema de Modelos Abertos (tec.dnn.lat)
- Tecnologia e Entretenimento: Samsung Lança Novas TVs Vision AI com Tela de 85 Polegadas no Brasil (lazer.pnn.lat)
- Volvo XC60 elétrico roda: análise da nova versão híbrida que promete autonomia de 200 km (pnn.lat)
- Galaxy Tab S10 FE Plus: Análise Completa com IA e Preço Histórico (tec.pnn.lat)
- A Divisão Global Sobre os Riscos da Inteligência Artificial (tec.pnn.lat)